Cuando el plan existe solo en papel: construyendo una recuperación ante desastres que resiste el primer día real
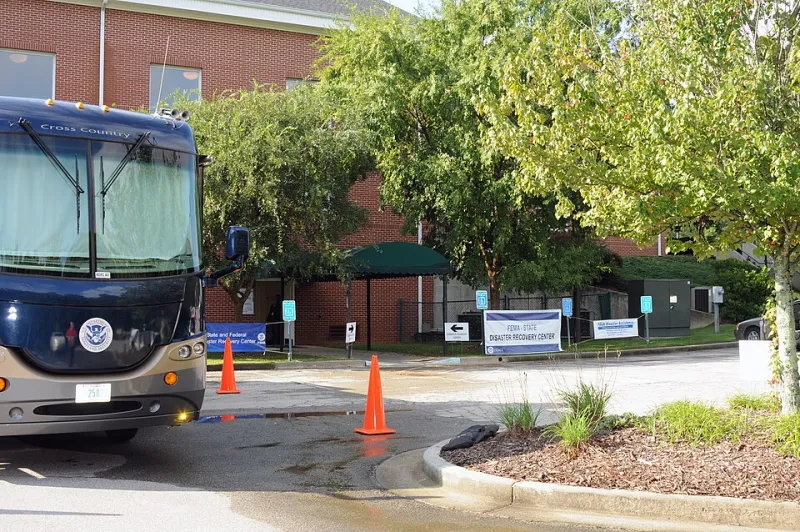
Photo: George Armstrong, Public domain, via Wikimedia Commons
Hay una escena que se repite en demasiadas empresas de la región: ocurre la falla, el equipo abre el archivador digital, encuentra el plan de continuidad actualizado hace cuatro años y descubre que el servidor que describe ya no existe. El plan existía. Simplemente nunca se ensayó.
La diferencia entre tener un plan y poder ejecutarlo
La recuperación ante desastres (DR) no es un documento, es una capacidad operativa. Y como toda capacidad, se construye con tres elementos que el papel no reemplaza: infraestructura replicada, personas que saben qué hacer y ensayos que demuestran que todo funciona bajo presión.
Los cuatro cimientos de un plan que funciona
1. Clasificar antes de proteger
No todo merece el mismo nivel de inversión. El primer ejercicio es un análisis de impacto al negocio (BIA) que responda dos preguntas por cada sistema: ¿cuánto tiempo puede estar caído (RTO)? y ¿cuántos datos se pueden perder (RPO)? Un ERP que factura diariamente no tolera lo mismo que un catálogo interno de productos.
2. Elegir la estrategia acorde al presupuesto
Las opciones técnicas forman un espectro de costos:
- Backup tradicional en sitio externo: la opción más económica, con horas o días de recuperación.
- Replicación a la nube de sistemas críticos: balance razonable entre costo y velocidad, hoy accesible incluso para PyMEs.
- Sitio de contingencia activo-pasivo o activo-activo: reservado a operaciones donde cada minuto de inactividad tiene costo directo.
La clave está en combinar: proteger con replicación lo crítico y con backups lo secundario, en lugar de aplicar el estándar más caro a todo.
3. Documentar para quien no estuvo en la reunión
Un plan útil se escribe pensando en la persona que lo ejecutará a las dos de la mañana, sin acceso a los sistemas y sin el gerente de TI disponible. Eso implica runbooks paso a paso, árboles de decisión, contactos actualizados y credenciales almacenadas fuera de la infraestructura comprometida.
4. Ensayar, corregir, repetir
Un plan sin pruebas es una hipótesis. La progresión recomendada es:
- Prueba de restauración de backups (trimestral): recuperar archivos y sistemas en un entorno aislado.
- Simulación funcional (semestral): activar el plan de contingencia para un sistema crítico sin interrumpir la operación.
- Ejercicio completo (anual): conmutar a la infraestructura alternativa durante horas, medir tiempos reales contra los RTO definidos.
Cada ensayo genera hallazgos; cada hallazgo, una corrección. Ese ciclo es el plan.
Presupuesto: qué es razonable esperar
Para una PyME, un esquema de backups en la nube con replicación del sistema crítico y dos ensayos anuales suele representar una fracción del costo de un solo día de parada. Para grandes empresas, la inversión en DR se justifica por simple aritmética: el costo anual del plan rara vez supera el costo de una interrupción mayor no cubierta.
El enemigo no es el desastre, es la complacencia
Los planes dejan de funcionar porque la infraestructura cambia, el personal rota y las pruebas se posponen. Asignar un responsable, un calendario de ensayos y una revisión semestral del documento convierte la recuperación ante desastres en un proceso vivo. Porque el semáforo en rojo no avisa: solo revela qué tan bien se trabajó cuando todavía había tiempo.